Несмотря на опасения, что способность передовых моделей искусственного интеллекта находить уязвимости в ПО приведёт к массовой эксплуатации этих ошибок киберпреступниками, на практике всё оказалось иначе. В частности, менее 0,5 % уязвимостей, найденных ИИ компании Anthropic в рамках проекта Glasswing, действительно использовались в атаках.
Содержание статьи
- 1 В помощь студенту: обзор российских ИИ-сервисов для учёбы и закрепления знаний
- 2 Лучший процессор под DDR4 в 2026 году: AM4 против LGA 1700
- 3 Обзор смартфона Google Pixel 11 Pro: когда надо выпустить хоть что-то
- 4 Обзор смартфона Samsung Galaxy Z Flip8: исчезающий вид?
- 5 Мастерская локальных ИИ: салат картофельный с Qwen3.8
- 6 Компьютер месяца, спецвыпуск: выбираем мини-ПК для работы и развлечений в эпоху дефицита чипов памяти
- 7 Компьютер месяца — сентябрь 2026 года
- 8 10 флагманских процессоров Intel за 10 лет
В помощь студенту: обзор российских ИИ-сервисов для учёбы и закрепления знаний
Лучший процессор под DDR4 в 2026 году: AM4 против LGA 1700
Обзор смартфона Google Pixel 11 Pro: когда надо выпустить хоть что-то
Обзор смартфона Samsung Galaxy Z Flip8: исчезающий вид?
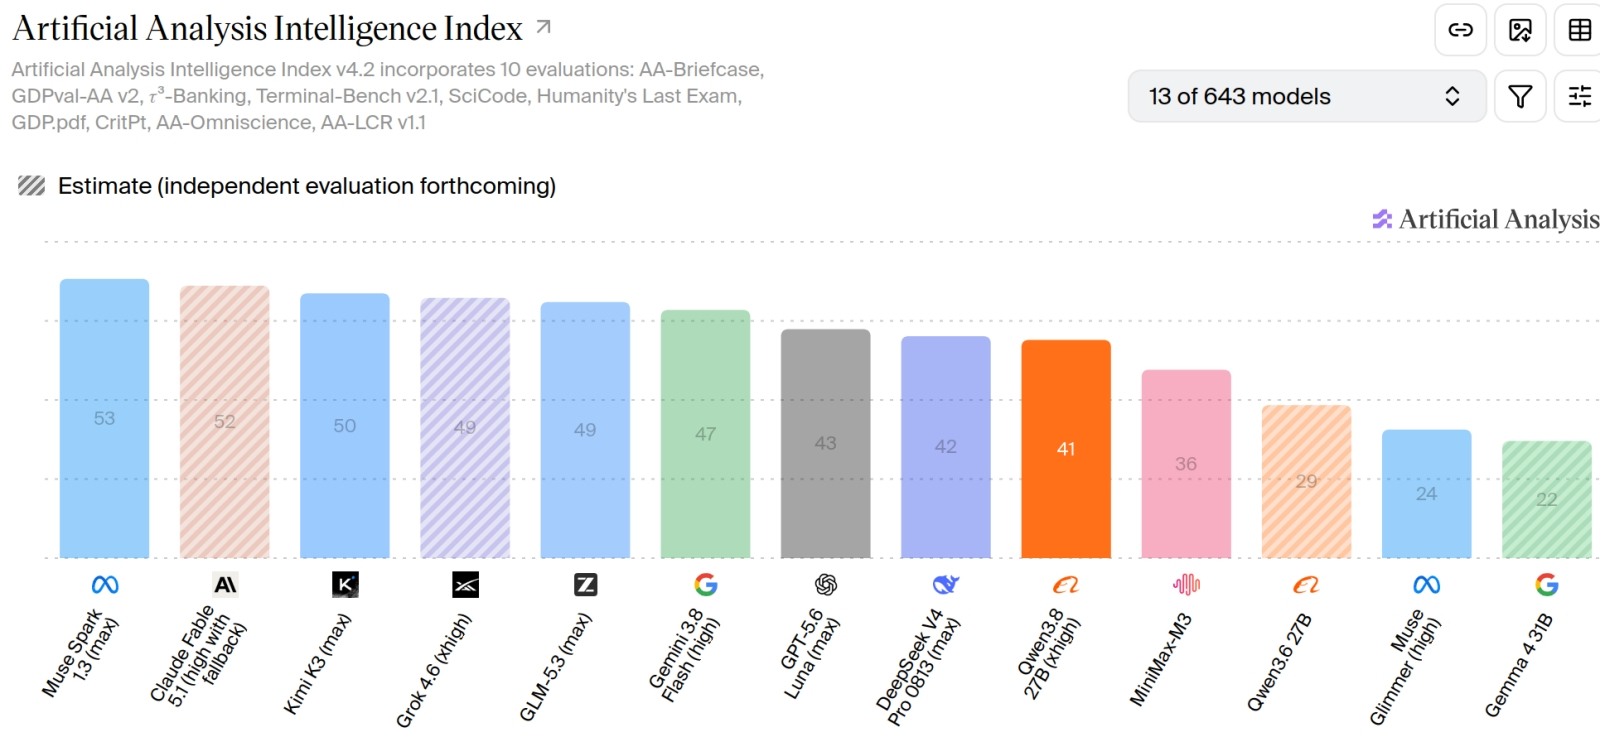
Мастерская локальных ИИ: салат картофельный с Qwen3.8
Компьютер месяца, спецвыпуск: выбираем мини-ПК для работы и развлечений в эпоху дефицита чипов памяти
Компьютер месяца — сентябрь 2026 года
10 флагманских процессоров Intel за 10 лет
Источник изображения: anthropic.com
А точнее, хакеры использовали лишь одну уязвимость из 225 официально зарегистрированных с номером CVE, которые удалось связать с проектом Glasswing по открытым каналам, заявил исследователь Патрик Гэррити (Patrick Garrity) из VulnCheck. Он начал отслеживать уязвимости, выявленные и официально зарегистрированные в рамках проекта Glasswing, вскоре после того, как Anthropic в апреле объявила об этой инициативе. Тогда в компании заявили, что выпуск передовой модели искусственного интеллекта Mythos в общий доступ грозит высокими рисками, потому что она беспрецедентно эффективна в обнаружении уязвимостей. К предварительной версии этой модели предоставили доступ только проверенным партнёрам Anthropic.
Тем временем Патрик Гэррити внёс в свой реестр только официально зарегистрированные в рамках проекта Glasswing ошибки и сверил их с индексом уязвимостей, реально используемых злоумышленниками. По состоянию на понедельник, 21 сентября, из 225 ошибок эксплуатировалась лишь одна — критическая уязвимость типа «SQL-инъекция» в платформе Ghost (CVE-2026-26980). «Есть большая разница между обнаружением уязвимостей и тем, полезны ли они для злоумышленников, и будут ли те ими пользоваться. Основной вывод, на который указывают эти данные, состоит в том, что обнаруженные и обнародованные Anthropic уязвимости оказали не такое большое влияние; судя по всему, они не влекут иных последствий по сравнению со случайной выборкой любых других уязвимостей», — сделал вывод исследователь.
Отметим, что хотя современные ИИ-модели научились эффективно находить уязвимости, исправляют их они пока не так качественно. Исследователи лаборатории Off-by-1 компании 1Password показали, что лишь в 26 % модели OpenAI GPT-5.5 и Anthropic Opus 4.8 полностью смогли устранить уязвимость; в 54 % случаев они либо не решали проблему, либо создавали новую уязвимость, либо делали и то, и другое сразу. «ИИ значительно снизил ворог входа в сферу обнаружения уязвимостей, но основной разрыв возникает на последующих этапах: координации, приоритизации, устранения проблем и развёртывании исправлений — это по-прежнему требует значительного участия человека, и в Anthropic с этим согласны. Кажется, они осознали это лишь после запуска проекта», — сделал вывод Патрик Гэррити.
Было интересно?
Скажите об этом Google, чтобы чаще получать ссылки на наши новости про искусственный интеллект