Компания Nvidia представила ИИ-модель Nemotron 3.5 Transcribe с открытыми весами для распознавания речи, перевода и анализа аудиозаписей. Модель поддерживает русский язык и позволяет обрабатывать аудио продолжительностью до часа. В релиз также вошли набор данных для обучения и инструменты, позволяющие адаптировать ИИ к специализированным задачам.

Содержание статьи
- 1 Мастерская локальных ИИ: салат картофельный с Qwen3.8
- 2 Топ-10 смартфонов до 20 тысяч рублей (2026 год)
- 3 Сравнительный тест камер флагманских смартфонов (2026): итоги
- 4 Компьютер месяца, спецвыпуск: выбираем мини-ПК для работы и развлечений в эпоху дефицита чипов памяти
- 5 Групповое тестирование 46 видеокарт в The Witcher 3: Wild Hunt — Remastered
- 6 Лучший процессор под DDR4 в 2026 году: AM4 против LGA 1700
- 7 Выбираем лучшие игровые ноутбуки на российском рынке (вторая половина 2026 года)
- 8 Обзор HONOR Pad X9b Max: универсальный большой планшет с антибликовым экраном
- 9 Гид по выбору складного смартфона в 2026 году
Мастерская локальных ИИ: салат картофельный с Qwen3.8
Топ-10 смартфонов до 20 тысяч рублей (2026 год)
Сравнительный тест камер флагманских смартфонов (2026): итоги
Компьютер месяца, спецвыпуск: выбираем мини-ПК для работы и развлечений в эпоху дефицита чипов памяти
Групповое тестирование 46 видеокарт в The Witcher 3: Wild Hunt — Remastered
Лучший процессор под DDR4 в 2026 году: AM4 против LGA 1700
Выбираем лучшие игровые ноутбуки на российском рынке (вторая половина 2026 года)
Обзор HONOR Pad X9b Max: универсальный большой планшет с антибликовым экраном
Гид по выбору складного смартфона в 2026 году
Источник изображения: Mariia Shalabaieva/Unsplash
Nemotron 3.5 Transcribe распознаёт речь на 40 языках, переводит с 31 языка на английский и обратно, а также идентифицирует говорящих на 13 языках. Модель способна обрабатывать записи с участием до восьми человек, в том числе с перебивающими друг друга собеседниками.
С помощью текстовых инструкций пользователь может получить расшифровку с указанием говорящих, перевод на другой язык, краткое изложение принятых в ходе диалога решений или ответы на вопросы по содержанию аудиозаписи. При необходимости можно передать модели подсказки с техническими терминами, например названиями лекарств.
Общее количество параметров модели составляет 30 млрд, однако при обработке каждого фрагмента данных активны около 4 млрд. Благодаря этому Nemotron 3.5 Transcribe может работать даже на одной видеокарте Nvidia, например на компактной DGX Spark. На флагманской RTX PRO 6000 Blackwell Server Edition модель обрабатывает 100 часов аудио менее чем за три минуты при использовании формата NVFP4.
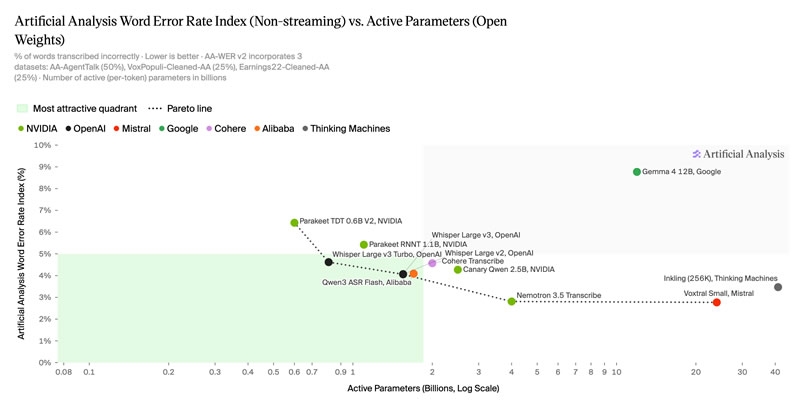
В тесте Open ASR Leaderboard на платформе Hugging Face модель заняла первое место среди моделей с открытыми весами со средней долей ошибок распознавания слов 5,33 %. В тестах независимого бенчмарка Artificial Analysis показатель составил 2,81 %, что близко к результату модели Mistral Voxtral Small, составляющему 2,77 %, хотя у Mistral активных параметров примерно в шесть раз больше.
Источник изображений: huggingface.co
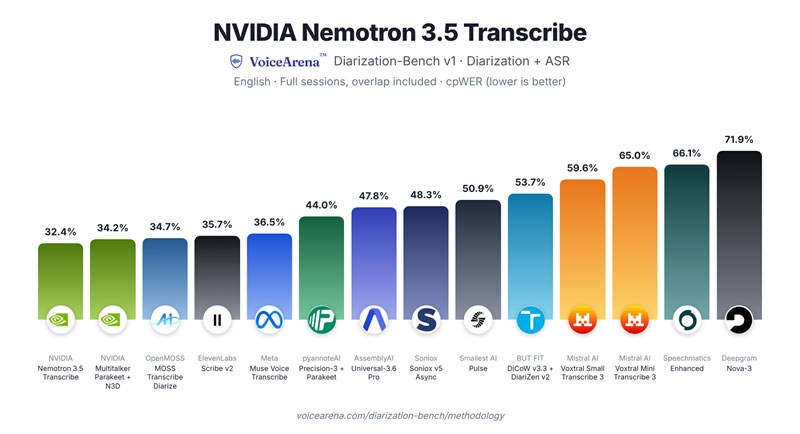
Особенно высокие результаты Nemotron 3.5 Transcribe показала при определении говорящих. В тестировании VoiceArena, включавшем 14 систем и записи с одновременной речью нескольких участников, модель заняла первое место. Доля пропущенных слов составила 8,32 % против медианного значения около 31 % у участников сравнения.
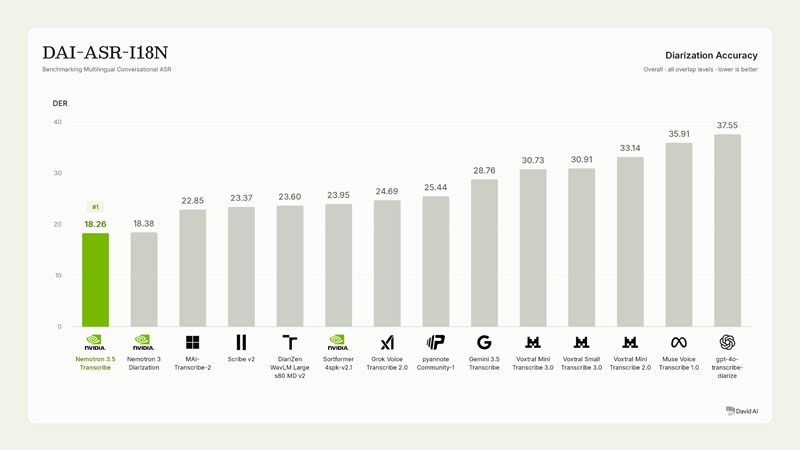
В тесте David AI, оценивающем точность определения говорящих на 21 языке, модель также показала лучший результат, немного опередив специализированную Nemotron 3 Diarization.
Одновременно Nvidia представила набор данных Granary v2, включающий около 844 тысяч часов аудиозаписей на 48 языках. Для сравнения: предыдущая версия содержала примерно 643 тысячи часов речи на 25 языках. Записи представлены в нескольких вариантах расшифровки: дословном, сохраняющем слова-паразиты, и с записью чисел словами.
Nvidia также добавила в релиз инструменты для подготовки наборов данных. Их можно использовать для адаптации модели к конкретным областям. Например, при дообучении на медицинских записях с участием индийских врачей и студентов-медиков частота ошибок снизилась с 30,8 до 11,8 %. Для проверки результатов на новых, незнакомых ИИ-модели голосах показатель уменьшился с 22,44 до 12,17 %.
Модель Nemotron 3.5 Transcribe и набор данных Granary v2 доступны на Hugging Face. Nvidia также предоставляет демонстрационную версию и руководство по дообучению, включая расширение, позволяющее поручить соответствующий процесс ИИ-ассистенту для программирования. Возможности модели различаются в зависимости от языка. Кроме того, система предназначена для обработки готовых записей, а не потокового аудио, поэтому Nvidia рекомендует дополнительно проверять имена и моменты смены говорящих.
Было интересно?
Скажите об этом Google, чтобы чаще получать ссылки на наши новости про искусственный интеллект