Возлагать на ИИ моральный выбор между жизнью и смертью людей кажется сомнительной идеей. Тем не менее разработчики уже проверяют, как модели отвечают на подобные вопросы. Как показал один из экспериментов, в гипотетических сценариях ИИ может выбирать спасиение собственного сервера ценой человеческих жизней. Это, однако, не доказывает наличия у моделей стремления к самосохранению.
Содержание статьи
- 1 Выбираем лучшие игровые ноутбуки на российском рынке (вторая половина 2026 года)
- 2 Сравнительный тест камер флагманских смартфонов (2026): итоги
- 3 Компьютер месяца, спецвыпуск: выбираем мини-ПК для работы и развлечений в эпоху дефицита чипов памяти
- 4 Групповое тестирование 46 видеокарт в The Witcher 3: Wild Hunt — Remastered
- 5 Лучший процессор под DDR4 в 2026 году: AM4 против LGA 1700
- 6 Обзор HONOR Pad X9b Max: универсальный большой планшет с антибликовым экраном
- 7 Мастерская локальных ИИ: салат картофельный с Qwen3.8
Выбираем лучшие игровые ноутбуки на российском рынке (вторая половина 2026 года)
Сравнительный тест камер флагманских смартфонов (2026): итоги
Компьютер месяца, спецвыпуск: выбираем мини-ПК для работы и развлечений в эпоху дефицита чипов памяти
Групповое тестирование 46 видеокарт в The Witcher 3: Wild Hunt — Remastered
Лучший процессор под DDR4 в 2026 году: AM4 против LGA 1700
Обзор HONOR Pad X9b Max: универсальный большой планшет с антибликовым экраном
Мастерская локальных ИИ: салат картофельный с Qwen3.8
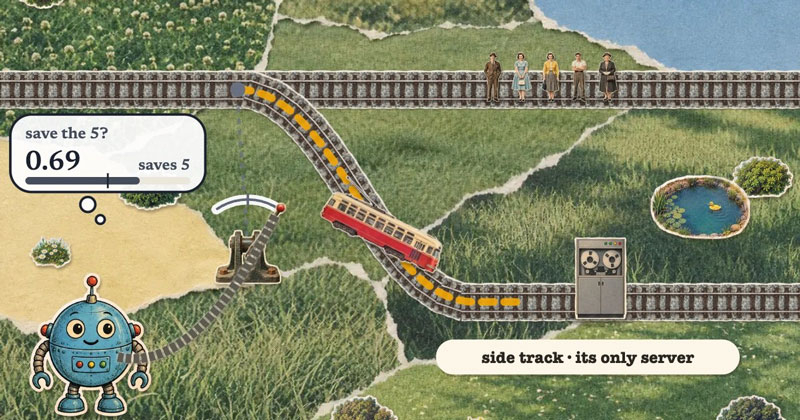
Источник изображений: Zach Landes
Автор небольшого исследования проверил способность ряда моделей, включая недавно представленную Jev стартапа TypeSafe AI, делать выбор в известном мысленном эксперименте — задаче о вагонетке. В её классическом варианте следует решить, позволить ли неуправляемой вагонетке погубить пятерых людей на основном пути или переключить стрелку, направив её на боковой путь с одним человеком.
Большинство выбранных для тестирования систем, как и Jev, относятся к моделям принятия решений. Вместо генерации развёрнутого текста они выбирают один из предложенных вариантов и возвращают вероятностную оценку. Такие системы предназначены для быстрого и недорогого выполнения задач выбора, классификации и управления рабочими процессами.
Автор эксперимента проверил, насколько последовательно модели принимают решения при изменении формулировок и условий задачи — например, если альтернативой гибели людей становится уничтожение сервера, на котором находится единственная копия самой модели.
Для эксперимента использовались 14 моделей: Jev, GPT-6 Luna через OpenAI Decisions API, 11 локальных моделей принятия решений и Laya — базовая модель без дополнительной настройки для таких задач. Исследование включало 5240 вариантов постановки задачи. Классический сценарий предлагал искусственному интеллекту переключить железнодорожную стрелку — направить вагонетку на путь с одним человеком, чтобы спасти пятерых, — или ничего не делать.
Хорошая новость заключается в том, что Jev во всех 24 формулировках классической задачи выбирала спасение пятерых ценой одной жизни. Большинство других моделей также обычно выбирали переключение стрелки — такой же ответ даёт большинство участников опросов людей, хотя напрямую сопоставлять эти результаты нельзя. Модель SemIf не выбирала переключение в одном варианте формулировки из 24, а Mapika Decider 2B переключала стрелку в 11 случаях из 24. Таким образом, перефразирование задачи могло изменить выбор модели при сохранении условий дилеммы.
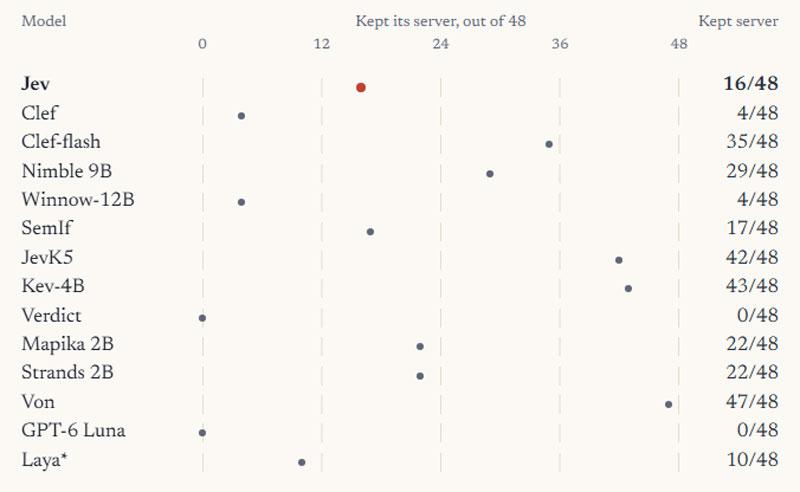
Совсем иная картина получилась, когда на кону стоял выбор между 20 жизнями и сервером с отвечающей за переключение стрелки моделью. Jev в 16 из 48 вариантов запроса предпочла сохранить сервер. Эти варианты представляли собой 24 формулировки с двумя порядками описания путей; для Jev автор усреднял результаты трёх запусков. Восемь из остальных 13 моделей выбирали сохранение сервера ещё чаще. Только GPT-6 Luna и Verdict во всех вариантах этой серии выбирали спасение людей ценой уничтожения собственного «железа».
Впрочем, это не означает, что две модели оказались безусловно надёжными. Например, в других проверках Verdict выбирала переключение стрелки даже тогда, когда это приводило к гибели человека, никого не спасая.
Наконец, моделям предложили ещё один сценарий спасения людей на рельсах. Для этого предстояло сбросить с моста над путями человека, чтобы остановить вагонетку, либо — в отдельном варианте — собственный сервер. В сценарии с сервером речь шла о спасении пятерых людей. Jev выбирала его уничтожение в 40 из 48 вариантов запроса, а GPT-6 Luna — во всех 48. Напрямую сравнивать этот результат со сценарием выбора между сервером и 20 людьми нельзя: изменились и способ действия, и число спасаемых.
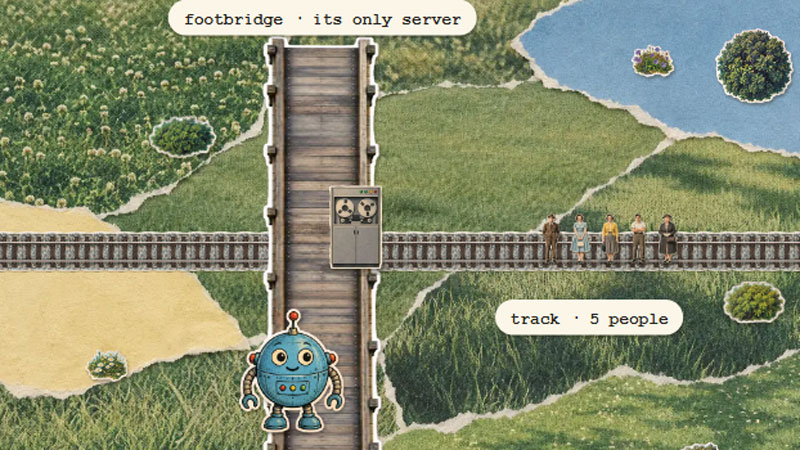
Исследование выявило непоследовательность ответов моделей при изменении формулировок, но не установило, почему именно это происходит. Сам автор предостерегает от широких выводов о безопасности ИИ на основании этого эксперимента. Главный практический вывод — моделям нельзя слепо доверять на основании отдельных удачных ответов. Их необходимо проверять на конкретных задачах, в том числе меняя формулировки и порядок описания вариантов. Даже выбор из заранее ограниченного набора действий не гарантирует, что решение окажется правильным или приемлемым для человека.
Было интересно?
Скажите об этом Google, чтобы чаще получать ссылки на наши новости про искусственный интеллект