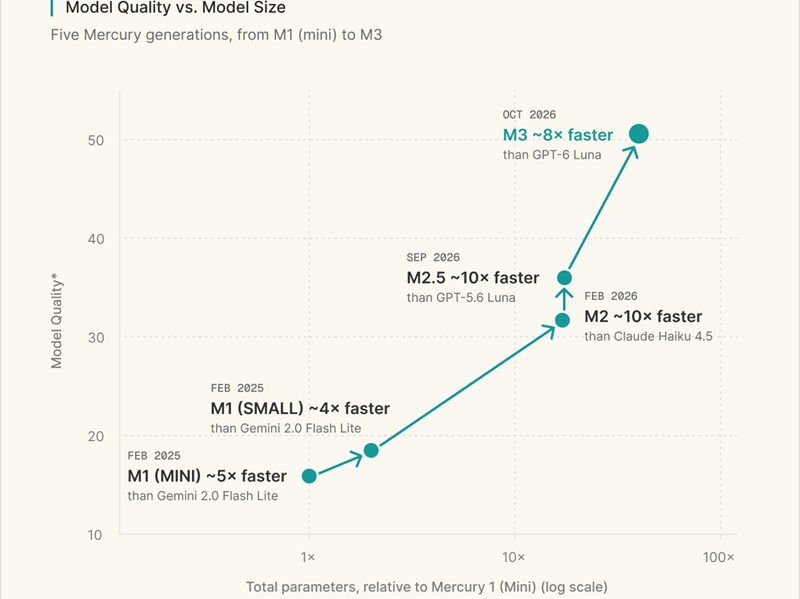
Компания из Редвуд-Сити (США) представила диффузионную большую языковую модель (dLLM) Mercury 3, которая в 40 раз больше предшественницы Mercury 1, но при этом отличается высокой скоростью работы — свыше 1000 токенов/с. В ряде тестов Mercury 3 превосходит GPT-6 Luna и Claude Haiku 5.5, работая при этом гораздо быстрее.
Содержание статьи
- 1 Сравнительный тест камер флагманских смартфонов (2026): итоги
- 2 Выбираем лучшие игровые ноутбуки на российском рынке (вторая половина 2026 года)
- 3 Гид по выбору складного смартфона в 2026 году
- 4 Топ-10 смартфонов до 20 тысяч рублей (2026 год)
- 5 Групповое тестирование 46 видеокарт в The Witcher 3: Wild Hunt — Remastered
- 6 Компьютер месяца, спецвыпуск: выбираем мини-ПК для работы и развлечений в эпоху дефицита чипов памяти
- 7 Мастерская локальных ИИ: салат картофельный с Qwen3.8
- 8 Лучший процессор под DDR4 в 2026 году: AM4 против LGA 1700
- 9 Обзор HONOR Pad X9b Max: универсальный большой планшет с антибликовым экраном
Сравнительный тест камер флагманских смартфонов (2026): итоги
Выбираем лучшие игровые ноутбуки на российском рынке (вторая половина 2026 года)
Гид по выбору складного смартфона в 2026 году
Топ-10 смартфонов до 20 тысяч рублей (2026 год)
Групповое тестирование 46 видеокарт в The Witcher 3: Wild Hunt — Remastered
Компьютер месяца, спецвыпуск: выбираем мини-ПК для работы и развлечений в эпоху дефицита чипов памяти
Мастерская локальных ИИ: салат картофельный с Qwen3.8
Лучший процессор под DDR4 в 2026 году: AM4 против LGA 1700
Обзор HONOR Pad X9b Max: универсальный большой планшет с антибликовым экраном
Источник изображения: Inception
В отличие от больших языковых моделей (LLM), генерирующих текст по одному токену за раз, диффузионные могут выдавать несколько токенов сразу, что даёт выигрыш в скорости.
Ранее разработчикам приходилось выбирать: либо использовать компактные и быстрые модели (для задач, критичных к задержкам), либо более мощные, но медленные аналоги. Mercury 3, как утверждает Inception, обладает и тем, и другим. Она значительно крупнее и функциональнее предшественников, но при этом по-прежнему работает со скоростью свыше 1000 токенов/с. При этом контекстное окно — объём текста, который модель может обрабатывать за один раз, — увеличилось до 1 млн токенов (в предыдущей версии Mercury 2.5 оно составляло 260 тысяч).
Согласно внутренним тестам компании, Mercury 3 превосходит GPT-6 Luna от OpenAI, Claude Haiku 5.5 от Anthropic и GLM-5.3 Flash от Zhipu по ряду показателей, работая при этом в 4–8 раз быстрее. «Ответы от таких моделей приходят практически мгновенно», — сообщил генеральный директор Inception Стефано Эрмон (Stefano Ermon).
Mercury 3 — четвёртая модель, выпущенная Inception с момента появления Mercury 1 в июне 2025 года. С каждой новой версией их функциональность росла, что не влияло на скорость работы. Так, в Mercury 2 появились механизмы логического рассуждения, в Mercury 2.5 — возможность настройки этих механизмов и контекстное окно объёмом 260 тысяч токенов. Mercury 3 совершила самый значительный качественный скачок в развитии линейки, утверждает разработчик.
Mercury 3 доступна через Inception API, Baseten, OpenRouter и Vercel. Благодаря совместимости с API OpenAI разработчики могут перейти на неё без необходимости переписывать код.
Стоимость использования Mercury 3 составляет $0,2 за миллион входных токенов и $0,7 за миллион выходных токенов. На этапе запуска компания снизила расценки вдвое — до $0,1 и $0,35 соответственно.
Было интересно?
Скажите об этом Google, чтобы чаще получать ссылки на наши новости про искусственный интеллект