Google представила Gemini 3.8 Flash TTS и Gemini 3.8 Flash-Lite TTS — две новые модели синтеза речи, которые превращают генерацию голоса из набора готовых вариантов в более гибкий инструмент для создания аудио. Модели позволяют создавать собственные голоса, управлять исполнением отдельных реплик и генерировать выразительные диалоги для игр, подкастов, аудиокниг и других проектов.
Содержание статьи
- 1 Мастерская локальных ИИ: салат картофельный с Qwen3.8
- 2 Компьютер месяца, спецвыпуск: выбираем мини-ПК для работы и развлечений в эпоху дефицита чипов памяти
- 3 Лучший процессор под DDR4 в 2026 году: AM4 против LGA 1700
- 4 10 флагманских процессоров Intel за 10 лет
- 5 Обзор смартфона Samsung Galaxy Z Flip8: исчезающий вид?
- 6 Обзор смартфона Google Pixel 11 Pro: когда надо выпустить хоть что-то
- 7 Компьютер месяца — сентябрь 2026 года
- 8 В помощь студенту: обзор российских ИИ-сервисов для учёбы и закрепления знаний
Мастерская локальных ИИ: салат картофельный с Qwen3.8
Компьютер месяца, спецвыпуск: выбираем мини-ПК для работы и развлечений в эпоху дефицита чипов памяти
Лучший процессор под DDR4 в 2026 году: AM4 против LGA 1700
10 флагманских процессоров Intel за 10 лет
Обзор смартфона Samsung Galaxy Z Flip8: исчезающий вид?
Обзор смартфона Google Pixel 11 Pro: когда надо выпустить хоть что-то
Компьютер месяца — сентябрь 2026 года
В помощь студенту: обзор российских ИИ-сервисов для учёбы и закрепления знаний
Источник изображений: Google
Gemini 3.8 Flash TTS предназначена для создания персонажей и детального управления их голосами. С помощью текстовых запросов можно задать роль, акцент и характеристики голоса более чем для 100 языков и диалектов. В библиотеке также доступно более 2000 готовых голосов, включая региональные варианты мексиканского испанского, квебекского французского и шотландского английского.
Отдельно Google добавила возможность клонирования голоса по 30-секундной аудиозаписи. Функция предназначена для собственного голоса или голоса, на использование которого получено право. Перед созданием копии система проверяет согласие владельца голоса, а полученное аудио защищается водяным знаком SynthID и метаданными C2PA.
После выбора голоса разработчик может управлять каждой репликой отдельно с помощью текстовых указаний. Gemini способна менять темп и характер исполнения, использовать шёпот и другие элементы звуковой подачи, а также добавлять реакции в виде смеха, вздохов и коротких реплик.
Обе модели поддерживают генерацию длинного аудио с сохранением качества, естественного темпа и характеристик голоса на протяжении нескольких часов, а режим двух говорящих позволяет создавать диалоги из одного сценария, сохраняя раздельные голоса и естественную очередность реплик. Gemini 3.8 Flash-Lite TTS при этом рассчитана прежде всего на масштабные проекты, включая дубляж, создание аудиоконтента и голосовых ИИ-агентов.
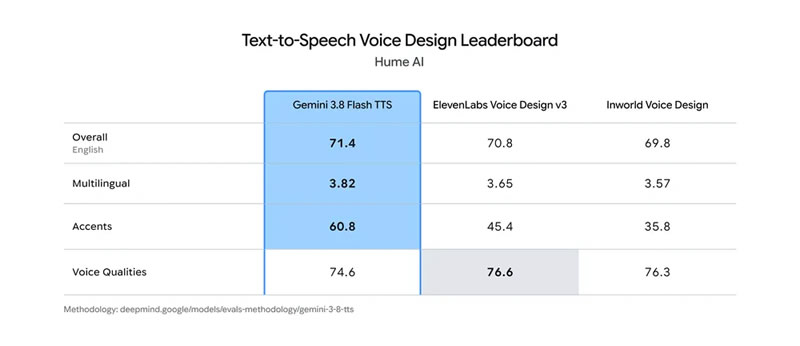
По данным Google, Gemini 3.8 Flash TTS заняла первое место в бенчмарке Voice Design компании Hume AI с результатом 71,4 балла, а в тесте моделирования акцента получила 60,8 балла. Flash TTS и Flash-Lite TTS также заняли первое и второе места соответственно в метрике Overall Quality Index (также от Hume AI). В слепых оценках пользователей на Voice Arena модели показали высокие результаты в японском, бразильском португальском, вьетнамском, современном стандартном арабском, мексиканском испанском и хинди.
Новые модели доступны с сегодняшнего дня в Google AI Studio, где появился отдельный интерфейс для создания голосовых сценариев. Gemini 3.8 Flash TTS и Flash-Lite TTS также доступны через Gemini API, а их интеграцию анонсировали платформы Agora, LiveKit, Pipecat и Vercel.
Было интересно?
Скажите об этом Google, чтобы чаще получать ссылки на наши новости про искусственный интеллект